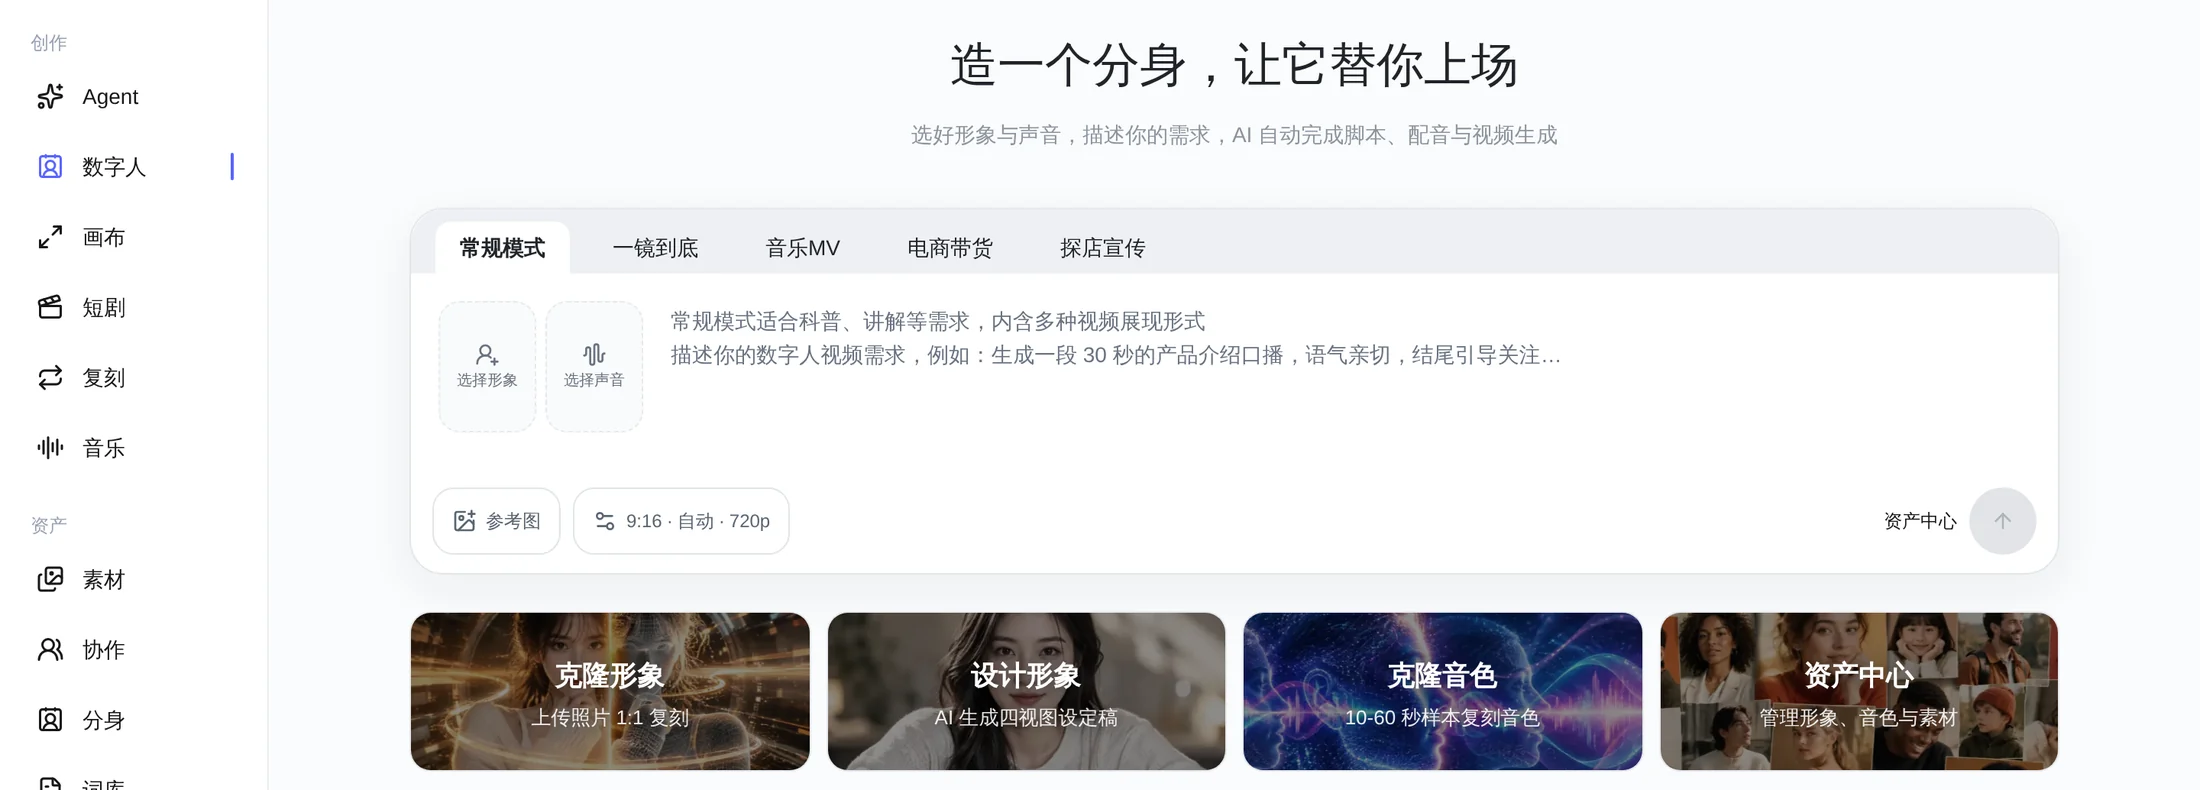
01 · Overview
认识数字人
数字人不是简单的「照片会说话」。它把形象、声音、脚本与镜头编排串成一条完整生产线:你只需要选好形象与声音,描述视频要讲什么,AI 会规划分镜、生成配音与画面,最后自动拼成一条可下载的成片。
快速答案
- 数字人支持五种模式:常规模式、一镜到底、音乐 MV、电商带货、探店宣传。
- 常规模式 30–150 秒;一镜到底 20–60 秒;音乐 MV 跟随歌曲;电商带货与探店宣传 20–80 秒。
- 克隆形象上传 1–3 张正面清晰人像;设计形象用文字与预设生成全新 IP。
- 音色克隆需要 10–60 秒清晰人声,支持 wav / mp3 / m4a,文件不超过 10MB。
- 完整流程:选形象与声音 → 描述需求 → 确认分镜 → 生成 → 预览下载。
一条视频是怎么被做出来的
选形象
从我的收藏、我的形象或公共形象中选择;需要专属形象时先去资产中心克隆或设计。
选声音
系统音色按性别、年龄、语言与场景筛选,也可以使用自己复刻的专属音色。
描述需求
写清主题、受众、结构、时长、语气与结尾引导;需要指定画面时用 @图1 引用参考图。
确认方案
AI 先给出分镜脚本与台词。确认后开始生成,也可以直接对话式改稿。
预览与下载
成片完成后在线预览、下载;单段不满意可重试,整体不满意可重新生成成片。
数字人创作是「先规划、后生成」的两段式流程。方案阶段不消耗视频生成时间,适合先把结构聊清楚,再开始生产。
02 · Audience
适合哪些行业与人群
只要需要「稳定出镜、批量表达、低成本更新」,数字人就有用武之地。
行业场景
- 知识科普与教育培训:课程章节、知识点拆解、政策解读、企业内训。
- 电商零售与品牌营销:商品卖点、活动促销、详情页视频、信息流投放。
- 本地生活与探店:餐饮门店、酒店民宿、文旅景区、到店团购。
- 医疗健康与金融服务:科普宣教、产品说明、合规口径统一的内容输出。
- 企业与政务宣传:品牌故事、招聘宣讲、通知公告、多语种版本。
- 自媒体与 MCN:日更口播、矩阵账号、IP 形象统一、批量本地化。
典型人群
- 不想出镜的创始人 / 负责人:用数字分身保持专业形象,减少拍摄时间。
- 讲师、顾问、知识博主:把同一套内容快速改写为多条短视频。
- 电商运营与主播团队:围绕不同商品批量产出带货素材,测试卖点。
- 门店老板与探店达人:无需反复到店拍摄,用场景图 + 数字人完成介绍。
- 市场与品牌团队:统一形象、统一音色、统一口径,降低外包沟通成本。
- 跨境与多语种团队:同一形象搭配不同语言音色,快速产出海外版本。
选择前先问自己三个问题
要不要像本人?
要保留真实五官,选「克隆形象」;要做品牌 IP 或不想露真容,选「设计形象」。
是一条还是多条?
单条口播用「一镜到底」更快;需要多个场景与信息层次,用「常规模式」。
有没有现成素材?
有歌做 MV;有商品图做带货;有门店场景图做探店。素材越具体,成片越贴近预期。
03 · Modes
五种创作模式
同一个首页,按内容目标切换模式。模式决定的是「怎么讲」,不是「能不能讲」。
五种模式都支持 9:16 与 16:9 两种画幅,默认 9:16;清晰度可选 480p / 720p / 1080p,默认 720p。除 MV 外,均可设置目标时长或交给 AI 自动规划。
常规模式
推荐新手适合科普、讲解、产品介绍等需要「多个镜头讲清楚一件事」的内容,内含多种视频展现形式。
- 目标时长 30 / 60 / 90 / 120 / 150s
- 自动时长 约 20–55s
- 分镜上限 最多 24 段
AI 会先拆解需求,规划钩子、铺垫、观点、演示、佐证、卖点、行动等分镜,再按分镜类型选择数字人、数字人长镜头、文生视频、图生视频、Web 动画或图文动效。
- 数字人分镜:5–15 秒/段,负责出镜口播与观点表达。
- 数字人长镜头:10–40 秒/段,适合完整章节讲述;单条视频最多 3 段。
- Web 动画:8–60 秒/段,用于数据、步骤、对比、金句等信息可视化。
- 图文动效:4–8 秒/段,用图片轮播承载氛围或案例。
一镜到底
连贯口播生成整段连贯完整的视频,观感像一次连续拍摄,适合单人口播与观点表达。
- 目标时长 20 / 40 / 60s
- 自动时长 约 8–28s
- 镜头结构 5–15s/段连续拼接
「一镜到底」强调叙事连贯:人物、场景、语气保持一致,观众不会频繁跳戏。自动时长超过 15 秒时,AI 会拆成 2–3 段连续生成,再拼接为一段完整视频。
- 适合单条口播、观点输出、Vlog 式讲解、活动致辞。
- 结构简单、生成更快、人物一致性更好。
- 不适合大量图表、商品特写或多场景切换。
音乐 MV
时长跟随歌曲上传歌曲音频,一键生成完整音乐 MV 片段。歌词按时间轴展示,不烧录进画面。
- 总时长 跟随歌曲长度
- 主角 形象 1 必选,形象 2 可选
- 分镜上限 最多 60 段
MV 模式不需要设置目标时长,整首歌就是时间轴。AI 会按歌词与段落编排唱歌镜头、空镜意境与长镜头特写。第二形象可用于对唱、合唱或第二角色。
- 唱歌镜头:5–15 秒/段,主力镜头,人物开口演唱。
- 长镜头特写:5–20 秒/段,全曲最多 3 段,用于点睛。
- 空镜意境:5–15 秒/段,承担转场、情绪与画面呼吸。
- 歌词字幕按时间轴在播放器中展示,不烧录进画面。
电商带货
商品图驱动围绕商品卖点与促销信息生成竖屏带货视频,适合详情页、信息流与直播切片。
- 目标时长 20 / 40 / 60 / 80s
- 场景图 最多 2 张
- 商品图 1 张(正/侧/背)
电商带货会围绕「痛点—卖点—优惠—行动」组织内容,镜头以数字人口播和商品展示为主。上传商品图时可标注正面、侧面、背面,场景图用于补充使用场景或直播间氛围。
- 推荐结构:3 秒钩子 → 核心卖点 → 使用场景 → 价格优惠 → 引导下单。
- 在需求中用 @图1、@图2 指定场景与商品,减少歧义。
- 投放抖音或视频号优先 9:16;详情页横版可切 16:9。
- 可开启「烧录字幕」,成片直接带字,适合投放。
探店宣传
本地生活用场景图串起「到店体验」的动线,适合餐饮、文旅、门店与本地团购。
- 目标时长 20 / 40 / 60 / 80s
- 场景图 最多 3 张
- 结构 人物动线与场景介绍
探店模式以「人物走进场景」为主线。建议按门头 → 环境 → 招牌产品/服务 → 价格或地址的顺序上传 3 张场景图,再用 @图1、@图2、@图3 描述动线。
- 推荐结构:门头钩子 → 环境氛围 → 招牌体验 → 价格/地址/团购引导。
- 动线示例:人物在@图1门口介绍,走到@图3前台,最后展示@图2的招牌菜。
- 可为每张图补充场景备注,帮助生成更贴合的提示词。
- 本地生活平台优先 9:16,适合团购与同城推荐。
模式只决定内容组织方式,不改变形象与音色。切换模式时,已选好的形象、声音与参考图会尽量保留;但时长档位会按模式自动校正。
04 · Duration & Settings
支持的时长与生成参数
先选模式,再按时长档位与画幅决定成片形态。
| 模式 | 可选目标时长 | 自动时长 | 单段结构与上限 |
|---|---|---|---|
| 常规模式 | 30 / 60 / 90 / 120 / 150 秒 | 约 20–55 秒 | 数字人 5–15s;长镜头 10–40s;Web 动画 8–60s;图文 4–8s;最多 24 段 |
| 一镜到底 | 20 / 40 / 60 秒 | 约 8–28 秒 | 5–15s/段;超过 15 秒自动拆为 2–3 段连续生成 |
| 音乐 MV | 跟随歌曲长度 | 不需要设置 | 唱歌 5–15s;长镜头 5–20s;空镜 5–15s;最多 60 段 |
| 电商带货 | 20 / 40 / 60 / 80 秒 | 约 20–55 秒 | 数字人口播与商品展示为主,按 5–15s 分镜组织 |
| 探店宣传 | 20 / 40 / 60 / 80 秒 | 约 20–55 秒 | 人物动线与场景介绍为主,按 5–15s 分镜组织 |
自动时长由 AI 按需求信息量判断;成片会因分镜吸收、配音长度与拼接产生少量偏差,这是正常现象。
05 · Avatar
克隆形象与设计形象
形象决定「谁在镜头前说话」。先选路线,再进入创作。
路线 A:克隆形象,1:1 复刻本人
上传 1–3 张正面清晰人像,AI 保留五官、脸型、肤色与气质,生成 16:9 四视图设定稿(正面 / 侧面 / 背面 / 面部特写),作为后续视频的形象参考。
- 适合创始人、讲师、主播、顾问等需要「像本人」的场景。
- 必填性别、年龄、身高、体重;精确数值会原样写入提示词。
- 可调表情、发型、服装、姿态;面部始终以参考人像为准。
- 通常 1–3 分钟完成,提交后可离开页面,完成后自动加入「我的形象」。
路线 B:设计形象,用文字创造新 IP
不依赖真人照片,通过性别、国籍气质、面部、表情、发型、服装、姿态等选项,加上年龄、身高、体重,生成一个全新的数字人形象。也可上传服装或发型参考图,切换为图生图模式。
- 适合品牌 IP、虚拟主播、匿名口播、系列化角色。
- 必填性别、国籍气质、年龄、身高、体重。
- 可选服装参考 1 张、发型参考 1 张、高级描述。
- 输出同样为 16:9 四视图设定稿,保存到「我的形象」。
四视图设定稿是什么
四视图包含正面全身、侧面、背面与面部特写。它不是最终视频画面,而是模型理解人物外貌的「设定资料」。生成视频时,正面形象图与四视图会一起作为形象参考,帮助保持人脸、发型与体型一致。
克隆形象的面部特征优先于文字指令;如果照片与填写的身材信息冲突,成片会优先参考照片。想调整服装或发型,建议用形象指令或重新生成。
公共形象与审核
私有形象可以申请公开,并设置最多 3 个类型标签(如营销带货、知识讲解、商务办公、医疗健康、金融服务、线下实体等)。审核通过后进入公共形象库;未通过审核的形象仍可作为私有形象正常使用。
06 · Voice
系统音色与音色克隆
声音决定「听起来是谁」。先用系统音色起步,再用克隆音色建立辨识度。
系统音色
内置数百个音色,可按性别、年龄、语言与适用场景筛选。每个音色都可试听,常用音色可收藏,创作时一键选用。
- 适用场景:知识科普、深夜电台、情感陪伴、商务演讲、电商直播、动漫配音、体育解说、智能客服等。
- 语言:中文、英文、中英混合。
- 优势:无需样本,立即使用;适合批量测试与多角色内容。
音色克隆(复刻声音)
上传或现场录制 10–60 秒清晰人声样本,生成专属音色。复刻完成后可在弹窗里做 A/B 对比:A 是原始样本,B 是复刻音色朗读同一段文案。
- 样本要求:wav / mp3 / m4a,≤10MB;安静环境、语速自然、单人说话。
- 克隆流程:校验样本 → 绑定 Qwen 合成模型 → 克隆 → 加入「我的音色」。
- 数量上限:每个用户最多 10 个克隆音色。
- 可用范围:数字人配音、短剧配音与音乐功能。
原声样本
约 19.8 秒 · 原始录音克隆时上传的原始录音,用于提取音色、音高与说话习惯。
克隆后试听
约 10.3 秒 · wen3 音色使用 wen3 克隆音色合成的示例文案,重点对比音色与语气。
原声是用于克隆的参考样本,克隆试听使用同一音色合成,两者内容不完全相同;对比时重点听音色、音高、语速与停顿习惯。正式使用前建议用你自己的文案再试听一次。
声音复刻请使用你本人或已获得明确授权的声音样本。不要复刻公众人物、他人声音或未经授权的影视角色声音用于对外发布。
07 · Workflow
从需求到成片
会写需求,比会调参数更重要。下面是一套可复用的写法。
需求写法:五件事说清楚
主题与受众
这条视频讲什么、给谁看。受众决定语气与信息密度。
结构与要点
开场钩子、3 个核心要点、结尾引导。要点越具体,分镜越不容易跑偏。
时长与画幅
投放平台决定 9:16 / 16:9;信息量决定 30s 还是 90s。
画面与素材
需要指定场景时上传图片,用 @图1 引用;说明景别、光线与风格。
行动引导
关注、点赞、下单、到店、私信。结尾没有引导,转化会明显变弱。
可直接套用的需求模板
主题:给第一次喝中国茶的人讲清楚「一片叶子为什么能流传五千年」
受众:25-40 岁、对茶感兴趣但不懂茶的都市白领
结构:开场用一个反常识问题抓注意力 → 讲 3 个关键历史节点 → 落到「今天怎么喝第一杯茶」
时长:60 秒左右,9:16 竖屏,720p
语气:亲切、有故事感,第一人称口播
画面:人物为主,穿插茶叶、茶汤、古画质感的图文动效
结尾:引导关注,并提示评论区领取入门茶单
字幕:简洁白字,关键词高亮
方案阶段:先看分镜,再开始生成
提交需求后,AI 会先进入「规划中」,生成分镜脚本与台词,状态变为「待确认方案」。这时可以逐段检查台词、画面描述、运镜、时长与字幕样式;可以直接对话式改稿,也可以在分镜详情里编辑或只重新生成单段。
生成阶段:可以离开页面
任务在后台执行,离开页面不会中断。完成后成片会自动出现在工作台与「最近创作」。如果某一段失败,可只重试该段;成片整体不满意,可重新生成成片。
「最近创作」会保留规划中、待确认、生成中、已完成与失败状态。失败任务会显示原因与重试入口,不需要重新填写全部需求。
08 · Demos
成片演示
来自真实创作记录的成片,分别演示常规模式与电商带货。
常规模式 · 30 秒竖屏
《三十秒读懂中国历史文化》· 9:16 · 720p · 4 段分镜
电商带货 · 26 秒竖屏
《炉甘石香皂特价 1.9 元》· 9:16 · 720p · 3 段分镜 · 高能弹跳字幕
09 · FAQ
常见问题
第一次使用时最容易遇到的几个问题。
为什么成片时长和设置的不完全一样?
视频由多个 5–15 秒分镜拼接,配音长度、分镜吸收与本地动画都会影响最终时长;自动模式由 AI 按信息量规划,因此会有少量偏差。MV 的总时长完全由歌曲决定,不需要设置。
一镜到底真的是一次生成吗?
观感上是一段连续视频。底层按 5–15 秒连续生成后自动拼接,保持人物、场景与语气一致;自动时长超过 15 秒会拆成 2–3 段连续生成。
数字人形象和本人不够像怎么办?
优先使用正面、清晰、无遮挡、光线均匀的 1–3 张人像;避免墨镜、侧脸、强滤镜与多人合影。克隆形象以参考人像的五官与脸型为准,换更清晰的照片通常比堆文字更有效。
为什么视频里的衣服和形象图不一致?
检查「服饰一致性」是否开启。开启后数字人穿着与形象图完全一致;关闭后 AI 会按场景自由设计服饰,但人脸保持一致。品牌制服、职业装建议保持开启。
克隆音色需要多长的样本?
建议 10–60 秒清晰人声,支持 wav / mp3 / m4a,文件不超过 10MB。环境安静、单人说话、语速自然、无背景音乐效果最好。复刻完成后可做 A/B 对比试听。
形象可以申请公开吗?审核不通过还能用吗?
可以。为形象设置最多 3 个类型标签后提交审核,通过后进入公共形象库。审核未通过的形象会显示原因,但仍可作为私有形象正常使用。
生成没有声音或口型不同步怎么办?
先确认已选择声音并试听正常,再检查该分镜是否成功生成。单段失败可在分镜详情里重试该段,不需要重做整条视频;整条成片异常时可重新生成成片。
生成的视频可以商用吗?
请确保你拥有形象、声音、图片、音乐与文案的相应授权,并遵守平台规则与法律法规。不要未经授权克隆他人形象或声音,也不要用生成内容误导他人。具体以站点服务条款与当地法律为准。
10 · Get Started
现在开始:第一条视频的最短路径
第一次建议用「常规模式 + 自动时长 + 9:16 + 720p」。
准备一个形象
直接选公共形象最快;想用本人,就去克隆形象上传 1–3 张正面照片。
选一个声音
先用系统音色试听,找到适合内容气质的音色;需要辨识度再做音色克隆。
写一段 60 秒需求
套用本页模板:主题、受众、结构、时长、画面、结尾引导。
确认方案并生成
检查分镜与台词,确认后开始生成;期间可以离开页面。
预览、下载、复盘
看成片节奏与字幕,记录哪类分镜效果好,下一次直接复用需求结构。